
- 2. Oktober 2026
- Veröffentlicht durch: Raoul Schneider
- Kategorie: NEWS
KI-Agenten brauchen mehr als gute Prompts
Generative KI ist in vielen Kommunikationsabteilungen angekommen. Doch der praktische Nutzen bleibt häufig hinter den Erwartungen zurück. Texte klingen plausibel, sind aber zu allgemein. Antworten berücksichtigen weder interne Positionierungen noch Markenregeln oder spezifische Zielgruppen. Der Grund liegt oft nicht im Sprachmodell, sondern in der Datenbasis.
Wer KI-Agenten für die Unternehmenskommunikation sinnvoll einsetzen will, muss deshalb früher ansetzen. Nicht beim Prompt, nicht beim Modell, sondern bei der Frage: Auf welches Wissen soll die KI eigentlich zugreifen können?
Vom Dokumentenbestand zur nutzbaren Wissensbasis
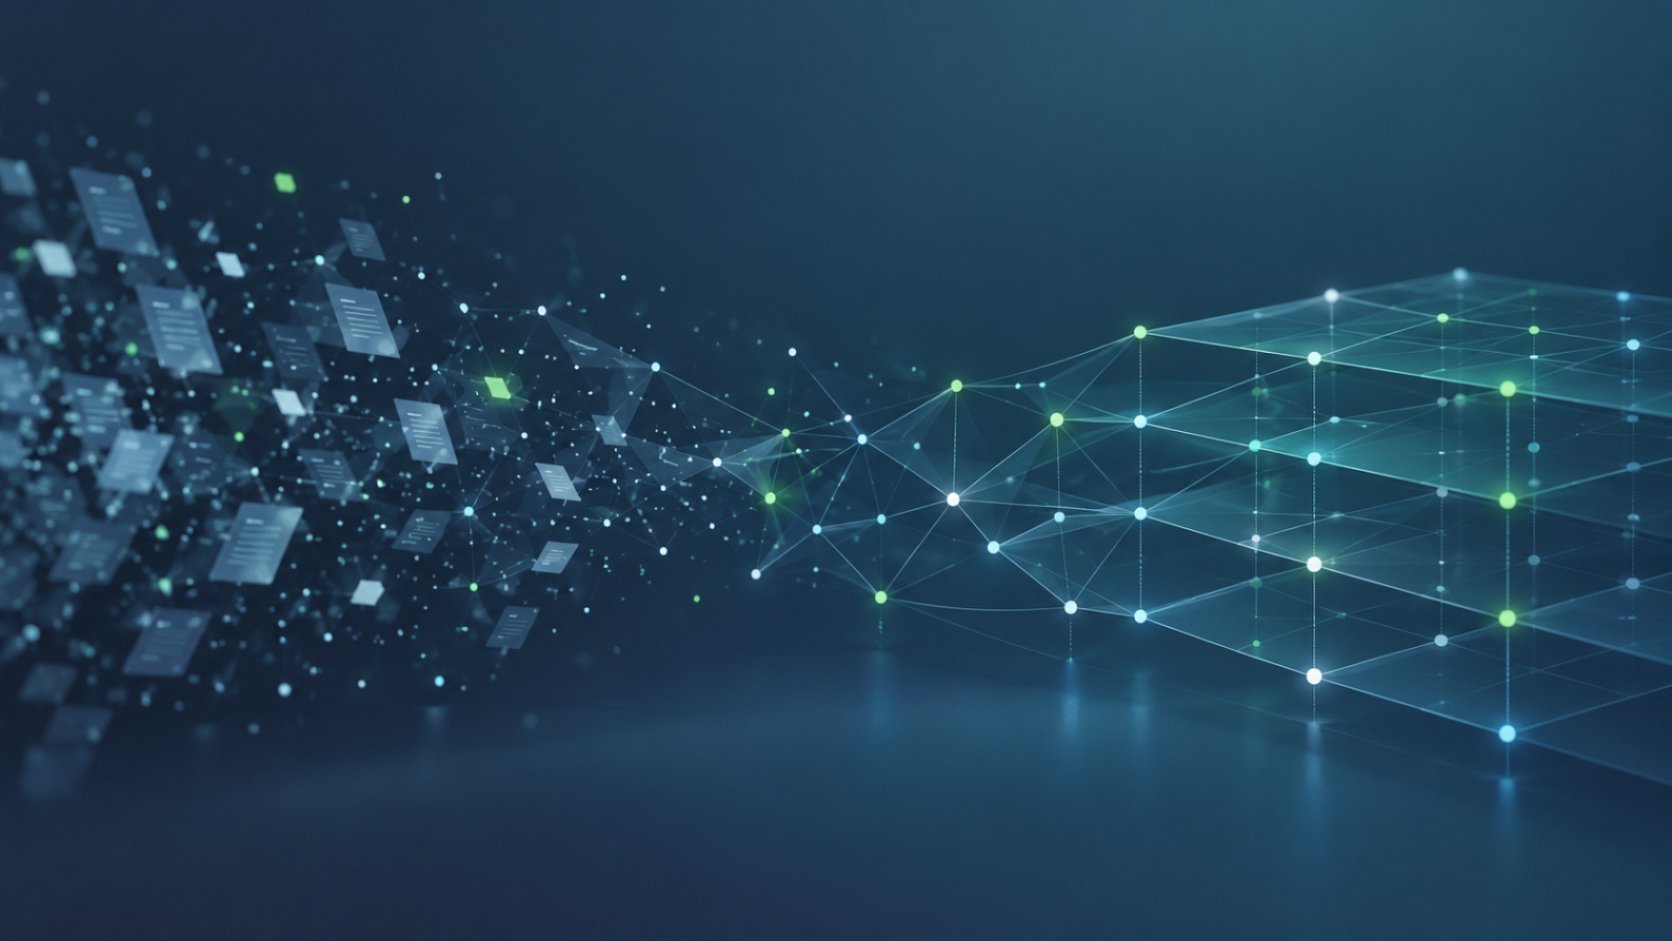
In Kommunikationsabteilungen mangelt es selten an Informationen. Das eigentliche Problem ist ihre Verteilung. Pressemitteilungen, Kernbotschaften, Positionierungspapiere, Markenrichtlinien, Websites, Intranet-Inhalte, Produktinformationen oder Marktkommunikationsmaterialien liegen häufig an unterschiedlichen Orten und in verschiedenen Versionen. Genau diese Fragmentierung verhindert, dass KI zuverlässig mit Unternehmenswissen arbeiten kann.
Der erste Schritt besteht deshalb darin, relevante Kommunikationsdaten zu identifizieren und zu bündeln. Dabei gilt ausdrücklich nicht: je mehr, desto besser. Entscheidend ist, welche Quellen tatsächlich für die jeweilige Aufgabe benötigt werden.
Aus einer Dateiablage wird erst dann eine KI-taugliche Wissensbasis, wenn Inhalte strukturiert aufbereitet sind. Dokumente müssen maschinenlesbar gemacht, in kleinere Informationseinheiten zerlegt und mit Metadaten versehen werden. Quelle, URL, Datum oder Version helfen dabei, Inhalte später gezielt zu finden und ihre Aktualität zu beurteilen. Die zentrale Erkenntnis lautet deshalb: Daten müssen nicht nur vorhanden, sondern auffindbar, aktuell und eindeutig zuordenbar sein.
Zielgruppe und Kanal müssen Teil der Logik werden
Unternehmenskommunikation funktioniert nicht nach dem Prinzip „ein Inhalt für alle“. Ein LinkedIn-Post folgt anderen Regeln als eine Pressemitteilung, ein interner Newsletter anderen als eine externe Website. Ebenso unterscheiden sich globale, regionale und lokale Zielgruppen.
Diese Unterschiede sollten nicht jedes Mal neu im Prompt beschrieben werden müssen. Empfehlenswert ist, sie systematisch in der Architektur des KI-Assistenten abzubilden. Dazu gehören beispielsweise Auswahlmöglichkeiten für interne oder externe Zielgruppen sowie regionale oder nationale Kontexte. Die Auswahl kann dann steuern, welche Datenquellen bevorzugt herangezogen werden.
Ebenso lassen sich für einzelne Kanäle feste Vorgaben hinterlegen: Struktur, Länge, Stil, Hashtags, Call-to-Action oder andere Formatregeln. Bei einer Anfrage kann der Agent dann zunächst bestimmen, für welchen Kanal produziert wird, welches Thema behandelt werden soll, ob zusätzliche Recherche nötig ist und welche Templates oder Beispiele zu berücksichtigen sind. Damit verschiebt sich ein Teil der Prompt-Arbeit in die Systemlogik. Das erhöht Konsistenz und reduziert die Abhängigkeit davon, wie gut einzelne Nutzer prompten.
Nicht alle Daten gehören in denselben Topf
Ein weiterer wichtiger Grundsatz lautet: Unterschiedliche Datenquellen brauchen unterschiedliche Zugriffswege.
Statische oder relativ stabile Inhalte wie Richtlinien, Positionierungspapiere oder freigegebene Kommunikationsmaterialien können zentral indexiert und über semantische Suche oder Vektorsuche auffindbar gemacht werden. Aktuelle oder dynamische Daten sollten dagegen möglichst direkt aus dem Ursprungssystem abgerufen werden.
Das gilt etwa für Markt-, Reputations- oder Befragungsdaten. Statt diese regelmäßig in eine Wissensdatenbank zu kopieren, kann ein KI-Agent die Intention einer Anfrage erkennen und die benötigten Werte über eine API live abrufen. Das Sprachmodell übernimmt anschließend die Aufgabe, die strukturierten Daten zu erklären oder zusammenzufassen.
Für Kommunikationsabteilungen ergibt sich daraus eine wichtige Architekturfrage: Welche Informationen gehören in eine zentrale Wissensbasis – und welche sollten zur Laufzeit direkt aus Quellsystemen kommen?
Data Ownership wird zur Kommunikationsaufgabe
Technisch saubere Datenzugriffe lösen nur einen Teil des Problems. Entscheidend ist, wer für die Inhalte verantwortlich ist. Gerade in internationalen oder dezentralen Organisationen werden Informationen lokal gepflegt. Eine zentrale Kommunikationsabteilung kann weder jede Länderwebsite noch jedes Produktdokument selbst aktuell halten. Deshalb braucht es klare Verantwortlichkeiten. Wenn die zugrunde liegenden Daten veraltet sind, arbeitet auch der beste KI-Agent mit veraltetem Wissen.
Data Governance darf deshalb nicht nur als IT- oder Compliance-Thema verstanden werden. Für die Kommunikation gehören mindestens drei Fragen dazu: Wer besitzt eine Information? Wer aktualisiert sie? Und woran erkennt das System, welche Version gültig ist?
Damit wird Data Ownership zu einer Voraussetzung für verlässliche KI-Kommunikation.
Aktualisierung möglichst automatisieren
Manuelle Datenpflege skaliert schlecht. Je mehr Quellen ein KI-Assistent verwendet, desto wichtiger werden automatisierte Prozesse.
Webseiten können regelmäßig gecrawlt, SharePoint-Bestände automatisch neu indexiert und neue oder aktualisierte Dateien über Workflows in zentrale Ablagen übernommen werden. APIs bieten sich dort an, wo Daten ohnehin strukturiert und aktuell vorliegen.
Das Ziel sollte sein, Aktualität nicht von manuellen Einzelaktionen abhängig zu machen. Je stärker die Datenpflege automatisiert ist, desto geringer ist das Risiko, dass der Agent mit falschen oder überholten Informationen arbeitet.
Kommunikation und IT müssen gemeinsam bauen
Sobald KI-Agenten auf Unternehmensdaten, Authentifizierung, Schnittstellen und Sucharchitekturen zugreifen, wird das Thema technisch anspruchsvoll. Kommunikationsabteilungen können solche Systeme kaum isoliert entwickeln.
Empfehlenswert ist deshalb eine frühe Zusammenarbeit mit der IT. Diese Kooperation benötigt allerdings Übersetzungsarbeit in beide Richtungen. Die IT muss verstehen, welche Kommunikationsquellen relevant sind, welche Inhalte verbindlich sind und warum unterschiedliche Zielgruppen unterschiedliche Kontexte benötigen. Die Kommunikation wiederum muss lernen, wie Datenstrukturen, Schnittstellen und technische Abhängigkeiten funktionieren.
Diese Zusammenarbeit entsteht nicht automatisch. Sie entwickelt sich über gemeinsame Projekte, klare Use Cases und kontinuierlichen Austausch. Im zugrunde liegenden Praxisbeispiel war genau dieser Lernprozess ein wesentlicher Bestandteil der Entwicklung.
Nicht mit dem Agenten beginnen
Für Kommunikationsabteilungen lässt sich daraus eine einfache Reihenfolge ableiten: Zuerst den Use Case definieren, dann die benötigten Daten bestimmen, anschließend Datenquellen strukturieren und Verantwortlichkeiten klären. Erst danach sollte der Agent gebaut werden.
Der umgekehrte Weg führt schnell zu einem leistungsfähigen Sprachmodell mit unzureichendem Unternehmenswissen. Das Ergebnis sind generische Antworten auf spezifische Kommunikationsfragen.
Auch die Erfolgsmessung sollte nicht zu früh auf vermeintlich exakte Einsparwerte verengt werden. Zeit- oder Kosteneffekte lassen sich häufig nur schwer sauber isolieren. Sinnvoller sind zunächst Fragen nach Nutzungsintensität, Zufriedenheit, verkürzten Arbeitswegen, häufigen Use Cases und wahrgenommenen Qualitätsverbesserungen.
Vom Assistenten zur Agentenarchitektur
Der nächste Entwicklungsschritt geht über einzelne Schreib- oder Recherchefunktionen hinaus. Perspektivisch können spezialisierte Unteragenten verschiedene Teilaufgaben übernehmen und in mehrstufigen Workflows zusammenarbeiten.
Denkbar sind beispielsweise Agenten für Krisenerstmeldungen, Interviewtrainings, Recherche, Bildsuche oder kanalbezogene Textproduktion. Eine übergeordnete Orchestrierung verteilt Aufgaben an spezialisierte Komponenten.
Damit steigen allerdings auch die Anforderungen an die Datenbasis. Je autonomer Agenten arbeiten, desto wichtiger werden verlässliche Quellen, klare Zuständigkeiten und nachvollziehbare Entscheidungswege.
Die wichtigste Investition liegt vor der KI
Die zentrale Schlussfolgerung ist deshalb weniger technologisch, als es zunächst scheint. Unternehmen brauchen nicht zuerst mehr KI-Funktionen, sondern bessere Voraussetzungen für KI.
Dazu gehören kuratierte Daten, eine zentrale oder zumindest integrierte Wissensarchitektur, Metadaten, klare Data Ownership, automatisierte Aktualisierung und definierte Regeln für Zielgruppen und Kanäle.
Die Arbeit daran ist nicht abgeschlossen, sobald ein Agent live geht. Daten verändern sich, neue Quellen kommen hinzu, Strukturen ändern sich und neue Use Cases entstehen. Datenmanagement wird damit zu einer dauerhaften Aufgabe der Kommunikationsfunktion.
Wer diese Grundlagen schafft, verbessert nicht nur den Output von KI-Agenten. Er schafft zugleich mehr Transparenz, Konsistenz und Ordnung in der Kommunikation selbst. Genau darin liegt der strategische Mehrwert: Nicht der Agent ist der Anfang. Der Anfang ist eine belastbare Datenbasis.
Interview: Was KI-Agenten in der Unternehmenskommunikation leisten
Wenn KI informiert: Wer gibt Orientierung?